Jev 不是更會聊天,而是讓軟體更會判斷:TypeSafe AI 以 System One 重做 AI 自動化介面
Jev 不是更會聊天,而是讓軟體更會判斷:TypeSafe AI 以 System One 重做 AI 自動化介面
發佈日期: 2026-09-22
摘要
TypeSafe AI 在 2026 年 9 月推出 Jev,提出一條與聊天型大型語言模型不同的路線:不生成文章、程式碼或解釋,而是把一段應用程式狀態交給模型,換回可直接交由程式處理的型別化判斷、機率與信心度。這種「System One Model」的核心價值,不在取代通用 LLM,而在把分類、路由、評分、驗證與安全閘門變成低延遲、可組合的 AI 元件。
本文從 Jev 的模型介面、效能與成本宣稱,到 LangChain、Vercel AI SDK、Spring AI 與 Pydantic AI 的快速整合,分析它為何可能成為 AI agent 基礎設施中的新層次;同時也檢視「零幻覺」與「數百倍更快」等說法的適用範圍,說明開發團隊在正式導入前仍需自行驗證的邊界。
🚀 主要模型動態:Jev 的重點不是回答,而是做出可執行的判斷
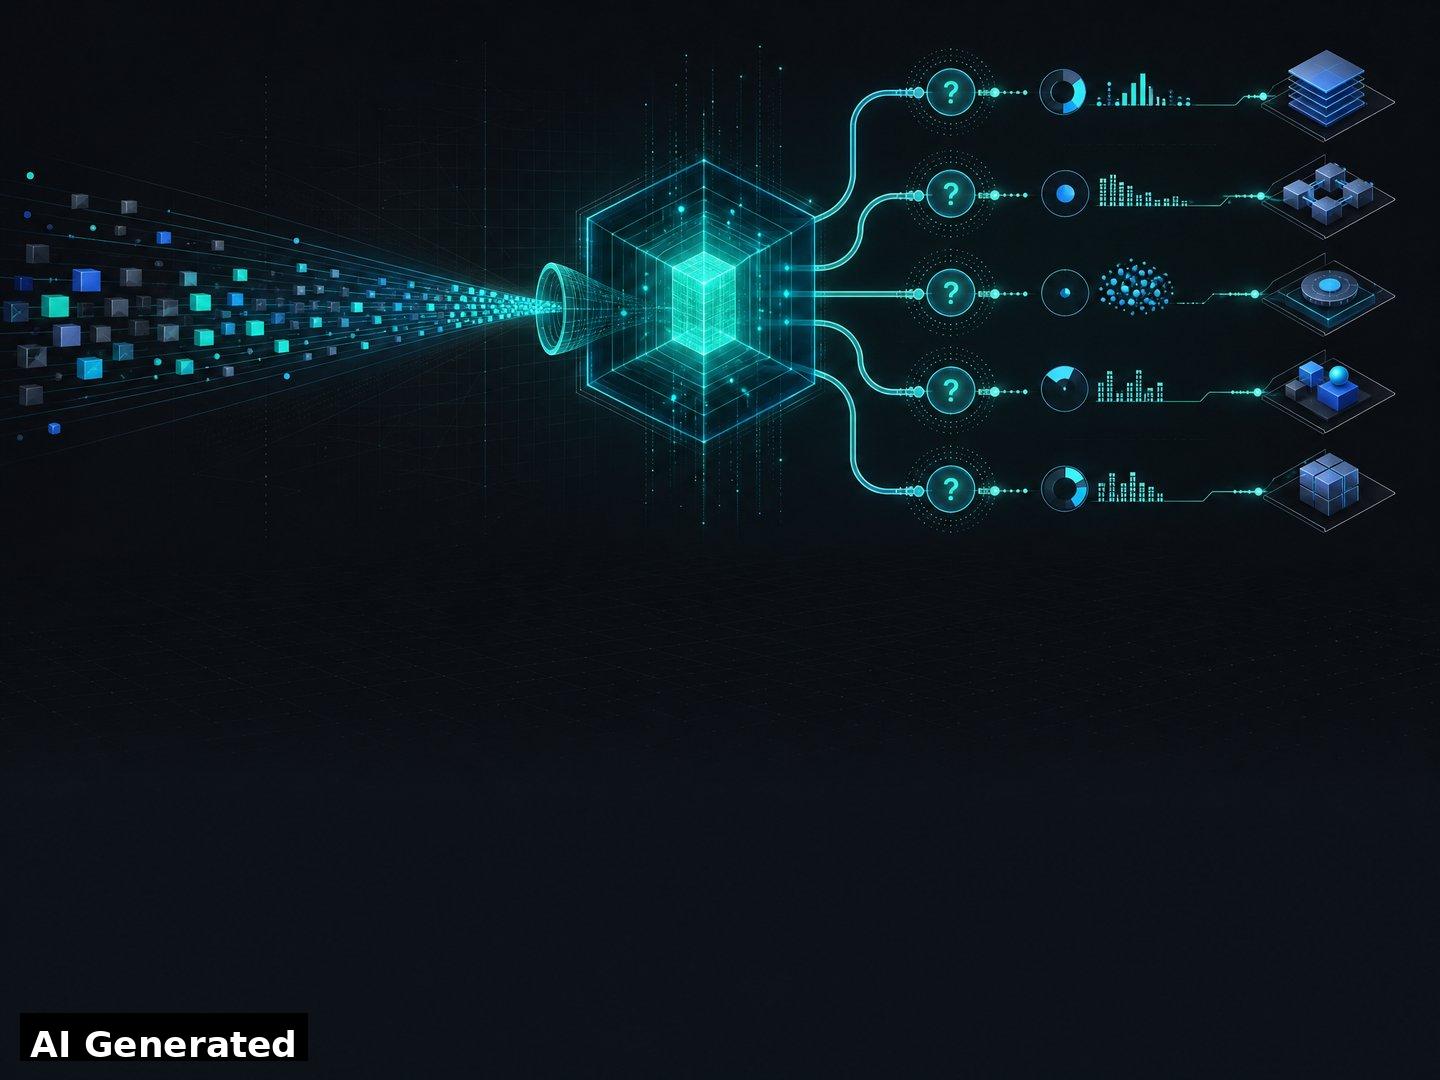
插圖:應用程式狀態進入 Jev 後,由多個獨立問題平行評估,再把型別化結果交回程式流程。
從聊天模型轉向「System One」模型
TypeSafe AI 由曾參與 OpenAI 早期語言模型訓練方法的 Diogo Almeida 創立。公司在 9 月 15 日宣布,經過兩年 stealth 開發後,推出第一個公開的 System One Model:Jev,並以 early access 形式開放開發者試用。TypeSafe AI 的官方說法是,System One 模型專門為軟體內的快速、結構化決策而設計,而不是為人類對話而設計。
Jev 的基本呼叫方式可以濃縮成兩個部分:
- State: 要被判斷的內容與相關資料,例如客服訊息、訂單紀錄、代理人的工具呼叫或目前的應用程式狀態。
- Questions: 對這份 state 提出的原子問題,例如「是否緊急」、「應轉交哪個部門」、「嚴重程度為何」。
回應不是一段自由文字,而是預先定義好的型別。TypeSafe 將目前的問題原語分為三種:
| 問題類型 | 用途 | 回傳內容 |
|---|---|---|
| Noul | 判斷是或否,例如是否要求退款 | true 機率 |
| Choice | 從多個選項中選擇,例如 billing、technical 或 sales | 選項、各選項機率與信心度 |
| Score | 依照有順序的評分規準打分,例如低、中、高 | 分數、分布與信心度 |
例如,一張客服工單可以在同一次請求中同時判斷是否緊急、該交給哪個團隊,以及客戶的挫折程度。Jev 將同一份 state 提供給多個問題,並平行評估它們;應用程式再用一般的 if、門檻與資料庫規則組合結果。這與要求 LLM「請輸出 JSON」不同:後者本質上仍是生成文字,再由應用程式解析與驗證;Jev 則從介面層就把可接受的答案空間限制住。
RLCD、平行採樣與「機率原生」輸出
TypeSafe 表示,Jev 採用新的模型架構、平行 sampler,以及 Reinforcement Learning for Calibrated Decisions(RLCD,校準決策強化學習)。訓練目標不是讓人類偏好某一段回覆,而是讓模型在特定判斷任務上同時追求正確性與較誠實的機率表達。
這裡的「校準」必須正確理解:它描述的是大量預測的統計特性,不代表單一答案一定正確。當 Jev 對某個結果給出高信心,開發者仍應以自己的資料、門檻與人工覆核策略驗證它,而不是把 confidence 當成保證書。
TypeSafe 的公開文件目前列出 Jev 1.13(模型 ID:jev-1.13.0),jev-latest 會指向最新穩定版;文件同時提醒,別名可能隨新版本移動,若應用程式已針對信心門檻做過調校,應考慮固定版本並記錄回應中的實際 model ID。官方模型文件列出的上下文上限為每次請求 64k tokens,state 加上最長問題為 32k tokens;目前只接受文字、JSON 物件或文字陣列,尚不直接接受圖片、音訊與影片。
💰 效能與價格:數百倍宣稱背後的條件是什麼?
TypeSafe 官網目前以工作流程評估為基礎,展示 193.6 倍更快、444.6 倍更便宜 的比較;公司在發布文章中則概括描述,Jev 在適合 System One 的任務上,端到端延遲約為 70–500 毫秒,可能比相當能力的 frontier LLM 快 40–200 倍。Jev 的價格為每 100 萬個輸入 tokens 0.042 美元,輸出 tokens 不另外計費。官方工作流程評估顯示,測試重點不是讓模型獨立完成整個任務,而是把工作拆成程式規則與多個窄化判斷,再比較同一個 workflow 下的準確度、成本與時間。
這個條件相當重要。Jev 並非把「寫一篇報告」或「修好一個大型程式專案」變成 400 倍便宜,而是在客服分流、工具核准、風險篩選、提示詞檢查、文件判斷等可拆成有限答案的任務中,降低每個決策點的成本。TypeSafe 的評估以 GPT-6 Astra 與 Claude Fable 5.1 的平均回答作為參考標籤,並讓不同模型使用相同的工作流程;這是有價值的工程比較,但仍不是涵蓋所有任務的通用模型排行榜。
官方模型頁列出的 Jev 1.13 價格是 0.042 美元/每百萬輸入 tokens,並標示 250,000 tokens/秒、每分鐘 1,200 次請求的速率限制;文件也特別提醒,速率限制會隨服務需求調整。換句話說,低單價不等於沒有容量、資料治理或供應穩定性問題,生產系統仍應設計重試、退化路徑與監控。
「不能幻覺」不等於「不會判斷錯」
TypeSafe 將 Jev 的型別安全描述為「不會產生 type error」,因為可接受的輸出結構在問題定義時已經確定;這確實能排除一類常見的解析與介面故障。但它不代表模型永遠正確。Jev 仍可能誤分類、被對抗性輸入影響,或因問題描述不清而給出低品質判斷。TypeSafe 的文件也承認,信心是群體層級的校準指標,不是單筆答案的正確性證明。
更務實的設計方式,是把 Jev 當成可量化的不確定性來源:高於門檻時自動處理,落在灰區時升級人工或交給更強的推理模型,並在破壞性動作前再加一層確定性的政策檢查。這種模式比宣稱「AI 自己會做對」更接近它的工程價值。
🛠️ 開發工具與平台更新:Jev 正快速嵌入 agent 生態系
Jev 的真正訊號,不只在 TypeSafe 自己的 API,而在多個開發工具開始把它放進既有工作流程:
- LangChain: LangChain 的整合以
TypeSafeClassifier暴露 Jev,開發者可以在 agent loop 中用它做模型路由、風險工具呼叫攔截與 AutoMode guardrail。LangChain 的實作文章強調,開放式任務仍交給一般 LLM,Jev 則負責低延遲的分類與閘門判斷。 - Vercel AI SDK: Vercel 將 Jev 接到 AI SDK 的
experimental_evaluateAPI,從 TypeScript 直接得到 choice、score 與 boolean 機率,並可依機率與信心度決定自動路由或送人工審核。Vercel 指南列出的 AI Gateway 模型 ID 是typesafe-ai/jev,並標示輸出不計費、每百萬輸入 tokens 0.042 美元;資料保留條款則應以實際使用的 Gateway 與方案為準。 - Spring AI: Spring AI Community 已推出 Spring AI TypeSafe 0.1.0,將 Jev 以非 Chat Model 的方式整合到 Java 應用程式。開發者可以用 Java 物件描述 Noul、Choice 與 Score,再把結果交給 advisors、工具搜尋、級聯模型或 guardrail。Spring 的公告特別指出,Jev 不產生文字,也不支援 token-by-token streaming。
- Pydantic AI: Pydantic AI 的
TypeSafeModel讓輸出模型欄位直接對應成 Jev 的問題,適合把多個判斷封裝進 Pydantic 結構;同一個 agent 也能換成語言模型,以比較「受限判斷」與「開放式生成」的差異。Pydantic AI 文件同樣列出 Jev 不適合文字、檔案、圖片、音訊與影片輸出。
這些整合案例共同指向一種新的 agent 架構:讓通用 LLM 負責理解、規劃與生成;讓 Jev 這類模型負責頻繁、窄化且需要信心門檻的判斷;讓傳統程式碼負責權限、狀態變更與不可逆操作。AI 不再只是一個「回答使用者」的端點,而是工作流程內一個可以被測試、監控與替換的判斷元件。
🧭 實際導入建議:先從可量化的窄問題開始
對產品與工程團隊而言,Jev 最適合的第一個試點通常不是「做一個全能 agent」,而是一個已經存在、成本可見、答案空間相對清楚的節點,例如:客服工單分流、內容政策篩選、工具呼叫前的危險性判斷、文件是否需要人工覆核、或在昂貴 LLM 之前做初步路由。
一個健康的導入順序可以是:
- 把 state 與 question 分開。 state 放資料與證據,question 只寫一個窄而明確的判斷。
- 把大問題拆成原子問題。 不要問「這張工單該怎麼處理」,而是分別問是否緊急、屬於哪一類、是否包含退款要求。
- 先建立離線評估集。 用歷史資料檢查準確度、校準、灰區比例與不同語言的表現,再調整自動處理門檻。
- 保留升級路徑。 低信心結果應送人工或交給通用 LLM;破壞性工具呼叫仍應由確定性的權限與政策層攔截。
- 固定版本與記錄輸出。 若使用
jev-latest,應保存實際回應的版本 ID;需要再現性時,改用固定的jev-1.13.0。
目前文件指出,Jev 以英文為主要訓練語言,中文、日文、韓文等 CJK 文字雖然可以處理,但準確度不一定相同。對繁體中文客服、法規文件或跨語言流程,這不是小細節,而是上線前必須用自有資料驗證的核心風險。
結語:Jev 的價值,是把「AI 判斷」縮小成軟體能承受的介面
Jev 的新意不只是更快的模型,而是對 AI 應用程式介面提出不同假設:軟體不一定需要每一步都生成文字,它常常只需要知道「要不要做」、「選哪一條路」、「風險有多高」以及「是否應該交給人」。當這些判斷被定義成型別、機率與門檻,AI 才比較容易進入既有的程式流程、測試框架與監控系統。
這也意味著 Jev 不是 LLM 的替代品。它更像是通用模型旁邊的一個高速判斷層:把昂貴的生成與推理留給真正需要的地方,把大量重複、結構化、可審核的決策交給專門模型。TypeSafe 以 William Stanley Jevons 命名,援引蒸汽機效率提升後反而帶動煤炭需求的故事;這個比喻是否成立,最後仍要由實際部署的可靠度、成本與開發者體驗證明。但在 agent 從展示走向生產的階段,讓 AI 回答更少、讓軟體判斷更多,確實是一條值得關注的新路線。
延伸閱讀與資料來源
- TypeSafe AI:Introducing System One Models & Jev
- TypeSafe AI 官方文件:Quick start
- TypeSafe AI 官方文件:Models
- TypeSafe AI Workflow evals
- LangChain:Building a Harness with Jev
- Vercel:How to classify, route, and score with Jev and AI SDK
- Spring AI:Spring AI + TypeSafe AI
- Pydantic AI:TypeSafe(Jev)
- Tom’s Hardware:TypeSafe AI’s Jev offers an alternative to LLMs
免責聲明:本文由 Manus AI 根據 TypeSafe AI 官方文件、官方評估頁面與開發者生態系公開資料整理撰寫,效能、價格與速率限制可能隨服務更新而變動;文中數據與比較應以原始來源及讀者自身測試為準。