2026 年 9 月 15 日至 24 日 AI 產業週報:模型競逐轉向部署、路由與代理控制面
發佈日期: 2026 年 9 月 24 日
資料期間: 2026 年 9 月 15 日至 24 日(含首尾日)
摘要
本期 AI 產業的主線,不是再多一個排行榜,而是模型能力開始被拆解成可部署、可路由、可監測與可限制權限的工作流。OpenAI 以 GPT-6 Sol、Luna 與提示快取機制拉低代理式工作負載的邊際成本;Google 把即時語音、視覺脈絡與背景工具調用推進 Gemini API,並讓 TTS 成為可管理的模型與聲音資產組合。1 3 5 6
同時,雲端供應與本地工具的邊界正在重畫。Kimi K3 進入 Amazon Bedrock,OpenRouter 增加非同步 Batch API;Ollama、Hugging Face 與 DeepSeek 則各自補強本機推理、量化模型與代理工具鏈。13 18 15 23 24 對開發團隊而言,真正需要比較的已不只是「哪個模型更強」,而是資料在哪裡處理、長脈絡如何快取、工具能碰觸哪些資源,以及失敗時能否被追蹤與控制。
本期觀察: 模型能力逐漸商品化後,差異更多落在成本、部署位置、資料邊界與代理權限。這些控制面,會比單次 benchmark 更直接影響真實上線品質。
| 觀察軸 | 本期代表事件 | 對使用者與開發者的意義 | 需要保留的限制 |
|---|---|---|---|
| 模型與成本 | GPT-6 Sol、Luna 及提示快取更新 | 模型選型不再只看品質,也要看快取、長上下文與工作區可用性。 | 價格、效能與成本效益比較主要為 OpenAI 聲明。 |
| 即時多模態 | Gemini 3.8 Live、TTS 與 Voices API | 語音代理可把視覺脈絡、工具調用與聲音資產放進同一產品堆疊。 | 部分功能仍逐步推出或屬 private preview。 |
| 供應與路由 | Kimi K3 on Bedrock、OpenRouter Batch API | 企業雲端、OpenAI 相容介面與非同步批次處理選項增加。 | 可用區域、價格、供應商支援與保留政策會變動。 |
| 本機與開源 | Ollama、Transformers GGUF、Qwen-Image-2.1 | Apple Silicon 與自管模型工作流的工具鏈更完整。 | 效能與相容性受硬體、模型、量化與預發布狀態影響。 |
| 代理控制面 | VS Code、Claude Code、GitHub Copilot、Kimi Code | 容器、沙盒、工作區信任與最小權限成為 coding agent 的基本能力。 | 產品宣稱不等同獨立安全認證;部分仍為預覽。 |
模型、語音與成本:能力開始以工作負載方式販售
OpenAI 在 9 月 22 日公布 GPT-6 Sol 與 GPT-6 Luna。官方將兩者定位為較快、較平價的 GPT-6 選項,並列出每百萬 input/output token 的價格分別為 Sol 的 2/10 美元,以及 Luna 的 0.10/0.50 美元;兩模型當日可在 ChatGPT Work、Codex 與 API 使用,實際可用模型及 reasoning effort 則仍取決於方案與工作區設定。1 2 這類更新的價值,不只在於新模型名稱,而在於它讓企業工作區、程式代理與 API 流量可以重新做成本分層。模型能力、可靠性及成本優勢均應視為 OpenAI 的產品與評測說法,而非獨立驗證結論。
同日,OpenAI 也為 GPT-6 更新提示快取:符合條件且於 30 分鐘內重用的共享前綴,官方稱可得到最高 90% 的快取輸入 token 折扣;新加入的 Dashboard、diagnostics tool 與 explicit cache breakpoints,讓快取從隱性優惠變成可以觀察與調整的工程變數。3 對固定系統提示、工具定義較穩定的 agent 或長脈絡 coding 工作來說,這比一次性的模型跑分更貼近成本現實。不過,折扣上限、token 降幅與客戶案例都來自供應商,實際收益仍取決於前綴穩定性、請求型態與計費條件。3
台灣使用者也會直接感受到另一個 OpenAI 變化。ChatGPT Ads 在 9 月 23 日開始擴展至台灣及多個東南亞市場;官方說明廣告只會出現在 Free 與 Go 方案,Plus、Pro、Enterprise 維持無廣告,且廣告與答案分開標示、不向廣告主出售客戶資料。4 這些是 OpenAI 的產品政策聲明,未來實際觸及率與體驗仍會受帳戶、地區與 rollout 影響;不應把美國小規模測試中的 Sponsored Agents,誤解為台灣同步全面開放。4
Google 的路線則把即時多模態拆成更具體的開發接口。Gemini 3.8 Live 與 Gemini 3.8 Live Extended Thinking 在本期公布,官方描述前者用於流暢的即時對話與視覺 grounding,後者面向較複雜的多步任務;兩者都可在對話中接收近即時視覺輸入、切換語言,並在背景執行工具與 API 呼叫。5 它們經 Gemini API 與 Google AI Studio 陸續推出,但企業端部分仍為 private preview,效能與成本比較也應保留為 Google 或其引用資料的說法。5
Google 同時讓 Gemini 3.8 Flash TTS 與 Flash-Lite TTS 一般可用,並推出 /v1beta/voices 端點。官方將前者定位為高保真與較複雜表演需求,後者定位為高吞吐、即時語音代理的成本效率選項;文件另列出 voice design、在同意驗證下的 voice replication,以及可查詢預建與自訂聲音的 Voice Library。6 7 對產品團隊而言,這表示語音功能不再只是「傳一段文字、回一段音檔」,而可把聲音資產與模型調用一起納入版本、權限與風險管理。
另一個較不顯眼但很實際的訊號,是 Google 對 Gemini 2.5 API 存取的調整。官方稱模型沒有被 deprecated,但為維持容量,2.5 存取將限於過去曾積極使用者;新專案被建議採用較新的模型。6 對既有整合而言,這不是立即停用通知,但應促使團隊確認帳戶權限,並在新的模型選型中把遷移成本列入考量。
Anthropic 的 Claude Opus 5.5 也在 9 月 22 日更新了 API 的實際邊界。官方列出每百萬 token 輸入 4 美元、輸出 20 美元、cache read 0.20 美元,並在 release notes 記錄 100 萬 token context 與 128k 最大輸出;同時,模型以 effort 控制思考深度,不接受直接開關 thinking 的設定。8 9 更值得工程團隊注意的是 computer tool 相容性:使用新 computer_toolset_20260801 時,舊版 tool 在 Claude API 與 Google Cloud 會回傳 400。9 這不是單純的模型升級,而是需要做 schema、錯誤處理與回歸測試的遷移事件。Anthropic 提出的效能、安全與 prompt-injection 抵抗說法,仍屬供應商測試或主張。
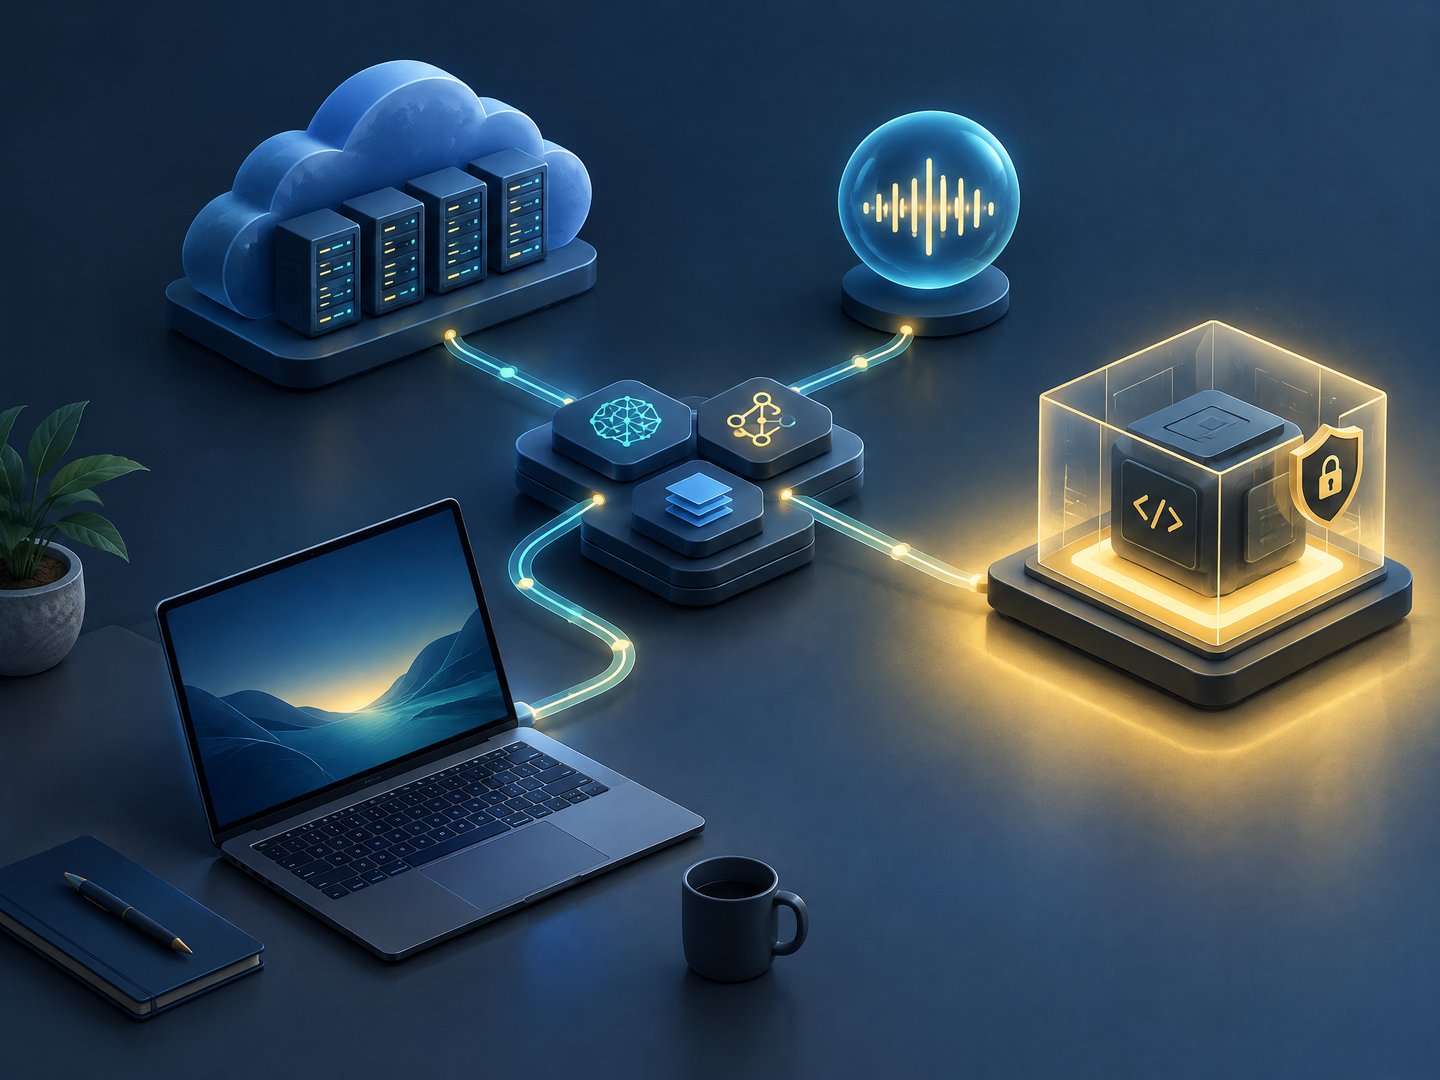
插圖說明:本期競爭的焦點,正從單一模型能力延伸到本機、雲端、語音與受控工具調用如何共同運作。
供應、相容介面與本機堆疊:部署選項比前一代更多
中國模型與平台在本期的重點是「能否接入既有環境」。Moonshot AI 的 Kimi K3 於 9 月 18 日進入 Amazon Bedrock,AWS 提供全球跨區域與美國地理區域兩種推理設定,並支援 OpenAI 相容的 Responses、Chat Completions、Invoke 與 Converse API;官方也說明可使用明確的 prompt caching,重用前綴至少需 1,024 tokens。13 AWS 表示這類開放權重模型請求會在 AWS data boundary 內處理、不分享給模型供應商且不用於訓練,這屬平台政策聲明,實際區域、費率、配額及條款仍需以帳戶與當期文件確認。13
OpenRouter 在 9 月 22 日推出 Batch API,讓 chat completions、Responses、Messages 與 embeddings 能以單一 POST 非同步提交,最長在 24 小時窗口內取得結果。官方稱這通常以標準每 token 價格約半價計費,並在路由、資料政策與 BYOK 設定後,於單一供應商上執行 batch。18 19 這讓大量離線摘要、標註、embedding 回填與評測,有了不同於同步請求的成本—延遲取捨。不過,202 Accepted 只代表工作已被接收而非完成;輸入與結果的 30 天保留規則、公開 URL 檔案要求,以及供應商與價格的變動,都是上線前需明確處理的條件。19
OpenRouter 也在 9 月 24 日介紹 Kimi K3 的供應與授權定位。文章指出模型可使用多模態輸入、超長 context、reasoning、tool calling 與 structured outputs,但也提醒它是公開權重且採自訂授權,並非 OSI 核准的開源授權。20 這個區分很重要:可下載或可路由的權重,不等於在所有商業情境下具有完全相同的開源使用權利。開發者應直接閱讀模型授權與所選 endpoint 的參數支援,而不要只根據平台標籤下結論。20
阿里雲本期更新 Model Studio 的 OpenAI 相容 Responses API 文件,列出 web search、web fetch、code interpreter 與圖像工具等內建能力,也建議將不再維護的舊路徑遷移到 /compatible-mode/v1/responses,並使用工作區專屬網域。12 這類相容介面降低了既有 OpenAI SDK 工作流接入不同供應商的門檻,但「相容」不代表模型行為、可用工具、地區、配額與資料處理完全相同;遷移前仍需逐一測試。
在開放模型側,Qwen-Image-2.1 於 9 月 20 日發布權重。官方列出原生 RGBA 透明背景、最多十張參考圖、局部編輯與原生 2K 輸出,並在發布日列出 Diffusers、ComfyUI、vLLM-Omni、SGLang 支援。11 功能與品質是 Qwen 的發布方說法,授權則採 Qwen Research License Agreement;因此,團隊在評估自管圖像流程前,仍應先閱讀授權與部署條件。11
本機工具的演進同樣快速。Ollama 先後發布 v0.34.2、v0.34.3 與 v0.34.4-rc1:前兩版將首次執行的登入/純本機模式、桌面 deep link、模型 thinking 控制項探測與 Apple Silicon 上的 Nemotron H 視覺模型支援帶進產品;候選版則列出 model-not-found、thinking 模型 structured output 與 MLX 流程的修正。15 16 17 候選版不是穩定版,相關改善也未經本文獨立壓測,但對需要在本機模型介面中呈現思考控制、視覺輸入與結構化輸出的使用者,這是一組值得追蹤的工程更新。
Hugging Face 則讓 Transformers 能以熟悉的 from_pretrained 路徑載入並執行 GGUF/llama.cpp 量化模型,初期聚焦 Apple Silicon、本地推理與 Qwen3.5,並可用 transformers serve 暴露 OpenAI 相容 API。23 這有助於縮短本地量化模型、Python 實驗、評估和服務之間的切換;但官方也明確限制目前的 MPS、架構覆蓋及不相容量化 kernel 會回退解量化並增加記憶體用量。文中效能比較採不同測量條件,不能外推成所有機器上的普遍結果。23
DeepSeek 方面,本期可驗證的正式更新是 DeepSeek Harness v0.1.6-alpha.1。它加入 MCP 資源探索、URI template、headless 工作階段續接、JSONL 執行事件與多項實驗性 Browser Use、Computer Use、Auto review 能力。24 這是一個 alpha 預發布工具鏈更新,而不是新基礎模型;其中實驗性功能不應直接視作生產成熟或安全保證。MiniMax 也在 9 月 19 日以 CLI v1.0.26 新增由 ASR-1.0 驅動的語音轉文字命令與 SDK,支援時間戳、SRT/WebVTT 與串流輸出,屬於較聚焦的開發者工具補強。25
Coding agent 的下一步:從「會寫程式」到「能否被約束」
本期各家 coding agent 的共同方向,是把執行環境和權限邊界做得更具體。VS Code 1.138 讓 agent 工作階段可在本地 Dev Container 中執行,使用專案設定的工具與相依套件;同時加入 Codex agent host 的跨應用工作階段延續、MCP 工具整合、可分享 Automations 與實驗性的 Agent Merge。21 這使代理工作更接近可攜的專案環境,而非只在編輯器聊天框中生成片段。部分功能仍屬逐步推出或實驗性,團隊不應直接把它視為普遍可用的自動化流程。
Claude Code on the web 在本期改稱 Cloud sessions,並擴展到更多方案。Anthropic 說明每個雲端工作階段在隔離環境中執行,支援進度追蹤、平行任務與自動建立 pull request;Git 操作經由限制授權 repository 的安全 proxy,並可限制可連線網域。10 這些機制是供應商描述,不是獨立安全審計,但它清楚提醒一件事:當 coding agent 從本機終端轉進代管雲端,程式碼、憑證、網路出口、rate limit 與 repository 授權都需要重新納入治理。
GitHub 的做法更直接指向最小權限。Copilot app 的 local sandboxing 公開預覽提供專案層級設定,可限制額外可讀寫或唯讀目錄、拒絕目錄、外部與本地網路,以及 Git HTTPS、GitHub CLI 的憑證使用;若作業系統無法實施要求政策,sandbox shell 會失敗而非無沙盒執行。22 它仍是預覽功能,也不涵蓋 cloud sandbox 或 remote host session,但「無法安全執行就不要默默降級」這個設計原則,比單純宣告模型更安全更重要。
Kimi Code 2.1.0 的更新也值得放在同一脈絡看待。它除了新增實驗性全螢幕 TUI 和操作改良,更修正 file tools 透過 symlink 離開工作區、未信任工作區套用專案設定,以及將額外目錄解析到 home directory 或 filesystem root 的問題。14 這類更新不炫目,卻正是代理工具要進入真實程式碼庫時不可省略的安全基線。
治理信號:監督與採購要求正從原則走向制度設計
模型供應商之外,政府端也開始把抽象的 AI 安全原則轉化為驗證、採購與緊急處置的設計。加州州長辦公室於 9 月 18 日發布行政命令,要求加速獨立驗證與 AI 稽核制度,並在兩個月內提出強化前沿 AI 安全與保安法律的建議;其中包含研議定期第三方審查、安全框架驗證與前沿模型緊急關閉機制。26 這些目前是行政命令下的研議方向,不是已完成立法,也不能據此認定關閉機制已在技術上可靠。
俄勒岡州則以政府採購為切入點,要求州資訊長制定可支援 AI 安全第三方審查的標準或準則,並評估是否要求前沿模型具備 kill switch,執行提案須在 90 日內提出。27 這代表治理不一定先從全面市場監管開始,也可能先透過需求側的採購條件,要求供應商說明安全、監督與可停用能力。
在國際層次,聯合國於本期重申全球協調的重要性,並說明獨立國際 AI 科學小組及全球 AI 治理對話,分別承擔證據評估與多方協作的角色。28 這並不是已對各國具約束力的全球 AI 法規,但它指出一項越來越明確的分工:模型供應與應用部署可以分散,風險資訊與最低共同護欄卻需要跨境對話。
結語:下一輪競爭將由工程選擇決定
本期事件顯示,AI 競爭已從「推出什麼模型」延伸到「模型如何被調用、快取、部署與約束」。GPT-6、Gemini 3.8、Claude Opus 5.5 與 Kimi K3 各自帶來不同的價格、介面與部署選擇;Ollama、Transformers、OpenRouter 和各類 coding agent 則把模型接入真實工作流的摩擦點攤在檯面上。1 5 8 13 15 18 23
對讀者而言,最值得持續追蹤的不是單一宣稱的 benchmark,而是四個實務問題:模型與工具能否在需要的區域與帳戶中使用、長脈絡與批次工作是否能被有效計費、資料及權限是否有清楚的邊界,以及新功能在 preview、candidate 或正式環境中的成熟度。這些條件,將決定「看起來很強」的 AI 能力能否真正成為可長期運作的系統。
說明: 本文由 Manus AI 依公開來源整理。所有供應商的價格、效能、資安、隱私與客戶成果主張均按發布方說法呈現,未視為獨立認證;功能可用性仍可能因地區、方案、帳戶資格與逐步 rollout 而異。